
把一台跑了 57 天的 Arch 服务器,原样搬到一台新的轻量机
换服务器这件事我拖了一阵子。倒不是多难,是心里有点发怵。旧机器上那套东西已经稳定跑了 357 天没动过,动了就怕出事。
旧机器是一台阿里云 ECS,跑着 RustDesk 服务端和 frp 内网穿透。要换的原因挺操蛋:机器所属的那个账号控制台登不进去了,只剩下 SSH 还能连。趁还能连的时候赶紧把家当搬走,不然哪天 SSH 也断了,里面的数据就真的悬了。
新机器是一台轻量应用服务器,同地域。坑,就埋在这三个字里。
一、三个拦路虎
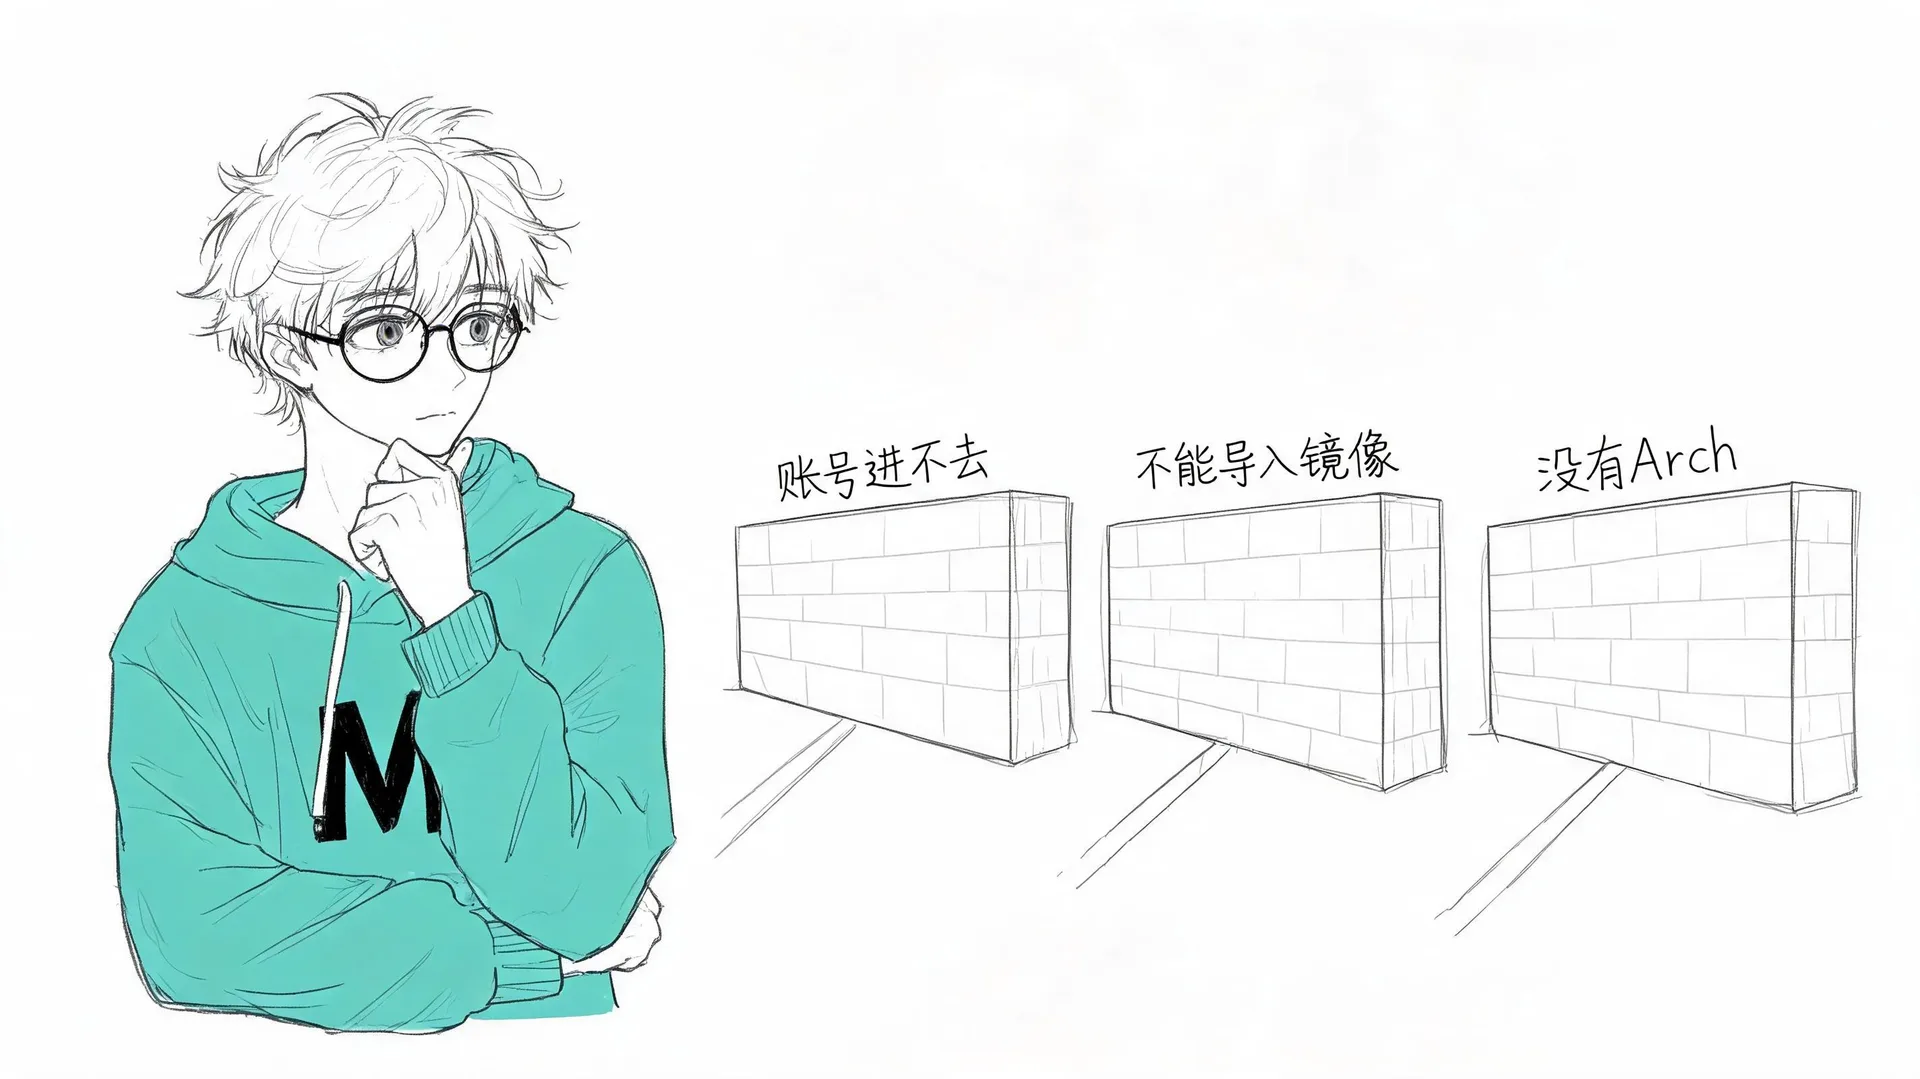
第一个,账号。旧机器的控制台登不进去,意味着所有跟「镜像」「快照」沾边的控制台操作都做不了。我手上只剩一条 SSH,别的啥也没有。
第二个,新机器是轻量应用服务器,不是 ECS。这俩名字听着像,能力差远了。ECS 支持导入自定义镜像、创建镜像、共享镜像,轻量通通没有。它只能重置成官方那几个系统,Ubuntu、CentOS、Debian、宝塔,翻来覆去就这些,没有 Arch。
第三个,我非 Arch 不可。旧机器就是 Arch,跑得好好的,新机器我也想要 Arch,把原来那套东西原样搬过去,数据零丢失。
三个条件叠一起,正常的迁移路子基本全堵死了。
二、方案怎么选
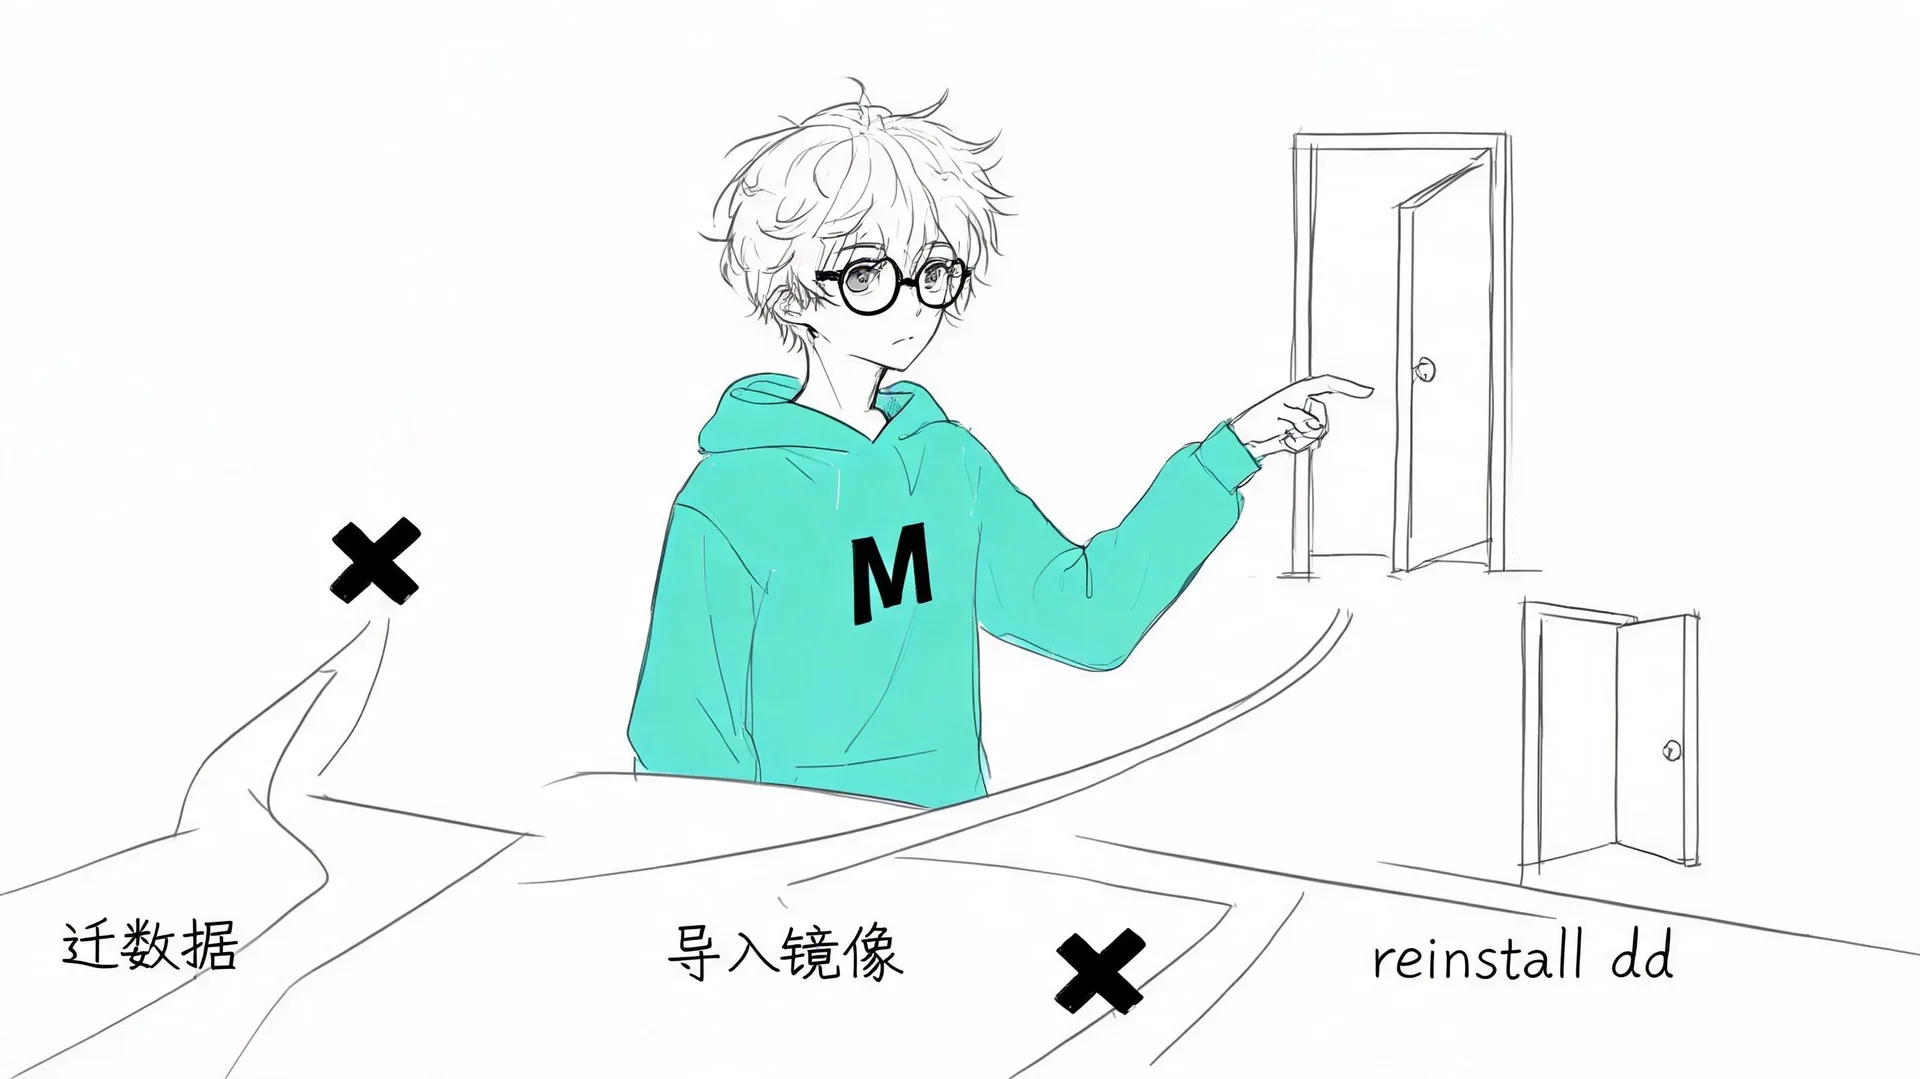
一开始我想的是最稳妥的路:迁数据。旧机器上就三个东西:RustDesk 服务端、frp,还有一个没启用的半成品。把数据 rsync 过去,新机器重装,服务重新拉起来。干净,没毛病。
问题是,新机器是轻量,官方镜像里没有 Arch。想在新机器上跑 Arch,要么导入自定义镜像(轻量不支持),要么手动装(VNC 挂着装,网速慢到想死)。
后来想到 ECS 那套导入镜像的路子。旧机器 dd 出个磁盘镜像,传到 OSS,导入成自定义镜像,再换系统盘。这条路在 ECS 上是通的,我甚至已经把 OSS bucket 建好了。
结果卡在一个意想不到的地方:轻量应用服务器根本没有「导入自定义镜像」这个入口。你翻遍控制台都找不到,因为它压根不支持这个功能。这条路直接死。
最后是 reinstall 脚本救的场。GitHub 上有个 bin456789 / reinstall 的项目,专门干这种「在云服务器上重装系统」的事。它支持 Arch,支持 dd 一个镜像 URL 直接灌进磁盘,还专门适配了阿里云轻量。关键是它对内存要求很低,512MB 就够。新机器只有 894MB 内存,手动装 Arch 会 OOM,但这个脚本不会。
于是路线定了:旧机器 SSH 里做镜像,传 OSS,生成签名 URL,新机器用 reinstall 脚本 dd 这个 URL。数据一步到位。
三、做镜像:30G 的盘只装了 3G,qcow2 却写出了 27G
做镜像这一步,是我这次踩坑最狠的地方。
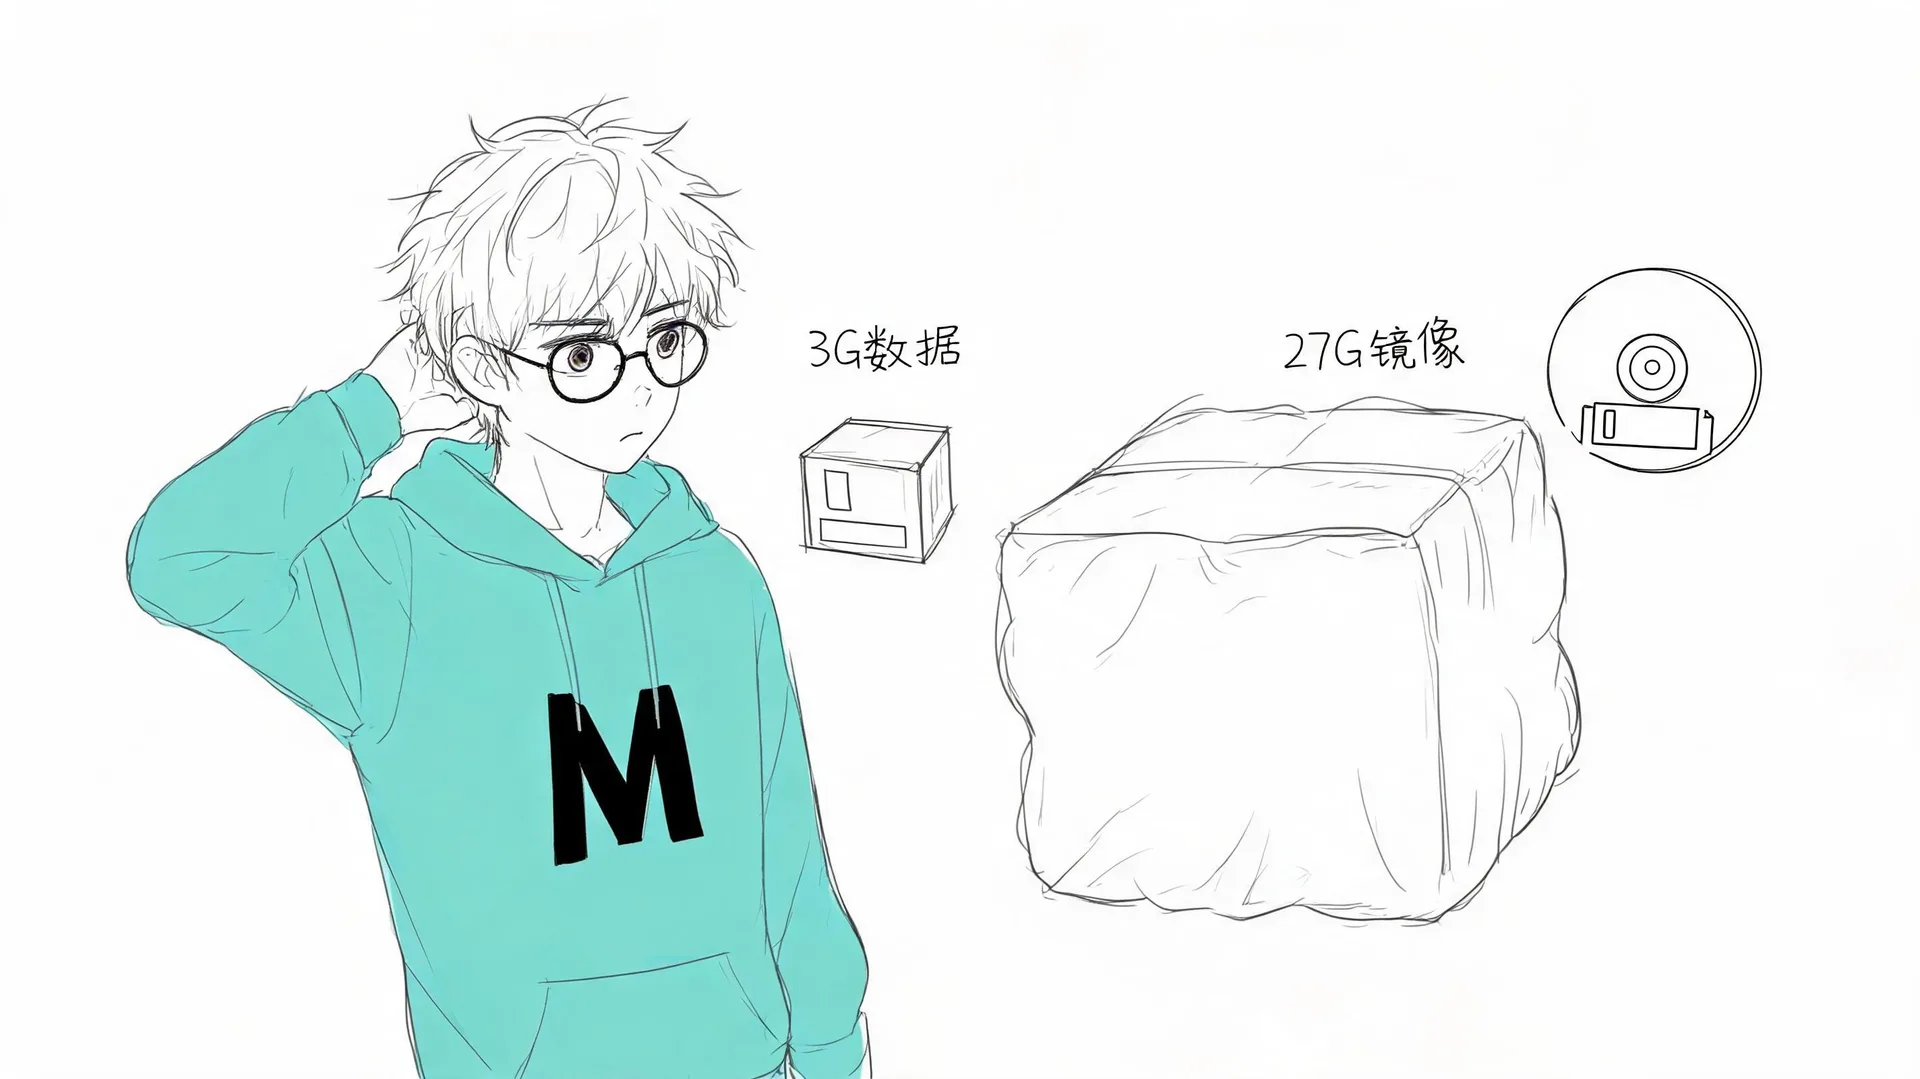
思路很简单:停掉服务,把整块 /dev/vda 转成 qcow2 稀疏镜像。30G 的盘实际只用了不到 3G,稀疏格式应该只写 3G 左右才对。
结果 qcow2 转出来 27G,直接把旧机器剩余磁盘写满了。
排查了半天,根因很隐蔽:阿里云的云盘不支持 discard。fstrim 一跑就报 not supported,discard_max_bytes 是 0。这意味着这块盘的空闲块不是零,里面是历史删除数据的残留,一块一块的非零垃圾。
qcow2 的稀疏化靠的是「读到的块是零就跳过」。你空闲块不是零,它就没法稀疏,只能把 30G 全量写出来。
解法也简单粗暴:先用 dd 写一个大文件把空闲空间填满零,再删掉那个文件。这样空闲块就真的变零了。
dd if=/dev/zero of=/root/zerofill bs=1Mrm -f /root/zerofillqemu-img convert -f raw -O qcow2 /dev/vda /root/arch-old.qcow2再转一次,qcow2 缩到不到 8G。虽然比 3G 还是大不少,但至少能放下了。
接着转 raw、压 zstd。reinstall 脚本的 dd 模式支持 raw 加上 .gz/.xz/.zst 压缩。zstd 压完 3.5G,只有原来的 11%。
这里还踩了个小坑:qemu-img 想直接输出到 stdout 省磁盘,结果它把 - 当成文件名,生成了一个叫 /root/- 的文件。老老实实写中间文件,分步删就没事了。
四、上传 OSS,和那张「假的 403」
镜像 3.5G,得传到 OSS 再给 reinstall 脚本下载。旧机器是账号 A 的,OSS 是账号 B 的,跨账号上传得用账号 B 的 AccessKey。
第一次上传,403。查了半天,是 RAM 用户的锅。我建了个 RAM 用户专门干这个,但忘了给它授权 OSS,连 ListBuckets 都 forbidden。去控制台加了个 AliyunOSSFullAccess,好了。
上传走的是内网 endpoint(oss-cn-shenzhen-internal),免流量,速度也快,3.5G 大概二十几秒传完。
然后是签名 URL。ossutil 的 sign 命令能生成一个带时效的签名下载链接,给 reinstall 脚本用。
这里有个特别坑的「假警报」:我用 curl -I(HEAD 请求)去测这个签名 URL,返回 403,以为链接有问题。折腾一圈才发现,这个签名是针对 GET 请求的,HEAD 跟它不兼容,所以 HEAD 永远 403。换成 curl -s(GET)就正常拉到了数据。
这个坑要是不注意,能卡你半小时。
五、dd 大法执行
正式动手前,先在轻量控制台给新机器建了个快照。dd 是要清空整盘的,万一失败还能回滚。这个兜底不能省。
然后在新机器上:
curl -O https://cnb.cool/bin456789/reinstall/-/git/raw/main/reinstall.shbash reinstall.sh dd --img '<签名URL>' --password xxxreboot脚本跑完「秒退」了。一开始我以为脚本坏了,其实这是正常流程,它只做配置,提示一句「重启后开始重装」,真正的重装要等你手动 reboot 之后才开始。
reboot 之后就是等。这期间我盯着端口,先看到 22 通了,心里一喜,结果两个密码都被拒。后来才反应过来,22 是重装环境的端口,不是 Arch 的。真正的 Arch 起来之后,SSH 在 2333 端口,那是旧机器上就改过的配置,跟着镜像一起过来了。
2333 通的那一刻,才算真成了。
六、验证,和那个「忘了自启」的容器
登录进去,系统是 Arch,IP 自动拿到了,网络通。逐项验证:
- frps 服务 active,端口 7115、7575 都在听
- RustDesk 的密钥和数据库文件完整
- frp 的证书齐全
- ufw 规则正确
几乎全过,就差一个:RustDesk 的两个容器 hbbs、hbbr 没起来。
原因是做镜像之前,我手动 docker stop 过它们。手动 stop 过的容器,镜像里就是停止态,dd 过去也不会自己起来。restart 策略(unless-stopped)在手动 stop 之后要手动 start 一次才会重新生效。
docker start hbbs hbbr一句话的事,但如果你没意识到这层,会以为容器挂了。
最后是系统更新。dd 过去的镜像内核还是旧的,pacman -Syu 一把升到最新,内核从 7.1.3 到 7.1.8,mkinitcpio 自动重建了 initramfs。重启一次,确认所有服务 enabled 且自启动正常,收工。
七、踩坑总表
| 坑 | 根因 | 解法 |
|---|---|---|
| qcow2 稀疏化失效、写满盘 | 云盘不支持 discard,空闲块非零 | dd 填零空闲块 |
| qemu-img 输出 stdout 报错 | - 被当文件名 | 写中间文件 |
| 签名 URL HEAD 返回 403 | 签名只认 GET | 用 GET 验证 |
| reinstall 脚本秒退 | 正常,需手动 reboot | 手动 reboot 即可 |
| 换机后网络不通 | networkd 用 MAC 绑定 | 改 Name = e* |
| 上传 403 | RAM 用户没授权 OSS | 加 AliyunOSSFullAccess |
| 容器没自启 | 手动 stop 后需手动 start | docker start 一次 |
| 安全组不通 | 系统 ufw 之外还有一层 | 控制台安全组放行 |
结尾
回头看,这次迁移难的不是技术,是信息差。轻量不支持导入镜像、官方没有 Arch、云盘不支持 discard,每一个坑都不是什么高深的东西,但都藏在文档的边角里,得你自己踩一遍才知道。
把一台跑了 57 天的服务器原样搬走,最后靠的是一个开源脚本加上几个 dd 和 qemu-img 命令。写下来,给下一位要搬家的人提个醒。
